给中国读者的英文 EPUB 阅读器。读英文书时,它按你的英语水平,自动给可能不认识的词、短语和复杂表达划上红线,点一下就能看到结合上下文的中文意思。
为什么做
那段时间我在读英文的设计书,生词很多:
这也是我最近的烦恼,读设计的书有很多陌生的词汇,导致我不想读,或者边读边查字典,很麻烦。所以想做这个功能。
想要的不是一个更快的词典,而是让人别在生词上卡住,能一直读下去。
设计
第一版只做核心功能:
登录和付款都是后面的事,先想核心功能。
- 打开一本 EPUB;
- 每翻到新的一页,AI 分析这一页,给可能不认识的地方划红线;
- 点划线的地方,看中文释义和词性;
- 以后想加:把不认识的词收进生词本,连同它的意思和所在的句子,再按类似 Anki 的方法复习。
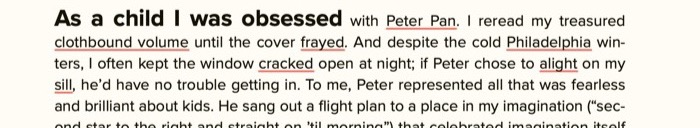
第一版的样子:读书时,生词和固定搭配下面自动出现红线。
我当时还记下一个没想清楚的问题:AI 没划到、我却不认识的词,该怎么办?
不用词表,让大模型判断
一般的做法是拿词频表和等级词表去比对。我没有这么做,而是把读者的情况写进提示词,让大模型直接判断:
- 读者档案:四级水平,词汇量约四千,学的是日常英语;
- 要标出五类东西:超出词汇量的生词、常见词的生僻意思(熟词僻义)、固定搭配和短语动词、专业术语、可能读不懂的复杂表达;
- 不标太简单的词;变形的词给出原形;短语要整个标出来(标 “take advantage of”,而不是单独标 “advantage”);
- 只输出结构化的结果:原文、原形、结合上下文的意思、词性。
这样省掉了自然语言处理那一套笨重的流程,代价是每一页都要调一次模型。
技术取舍
- 阅读器用 react-reader(基于 EPUB.js),模型用硅基流动上的通义千问,通过 Vercel AI SDK 调用;
- 一本书分析过的结果存起来,下次打开不用重算;按章节、分块慢慢分析,所以要记分析到哪儿了;
- 释义先交给大模型,以后可以接专业词典。
结果
做出了能用的第一版:读书、自动划线、点词看释义。之后没再往下做,但“在阅读里顺手学词”这件事,我还是觉得值得做。