
论文题目是《基于大语言模型和 Neo4j 的智能读书笔记系统的设计与实现》,指导老师由从哲。
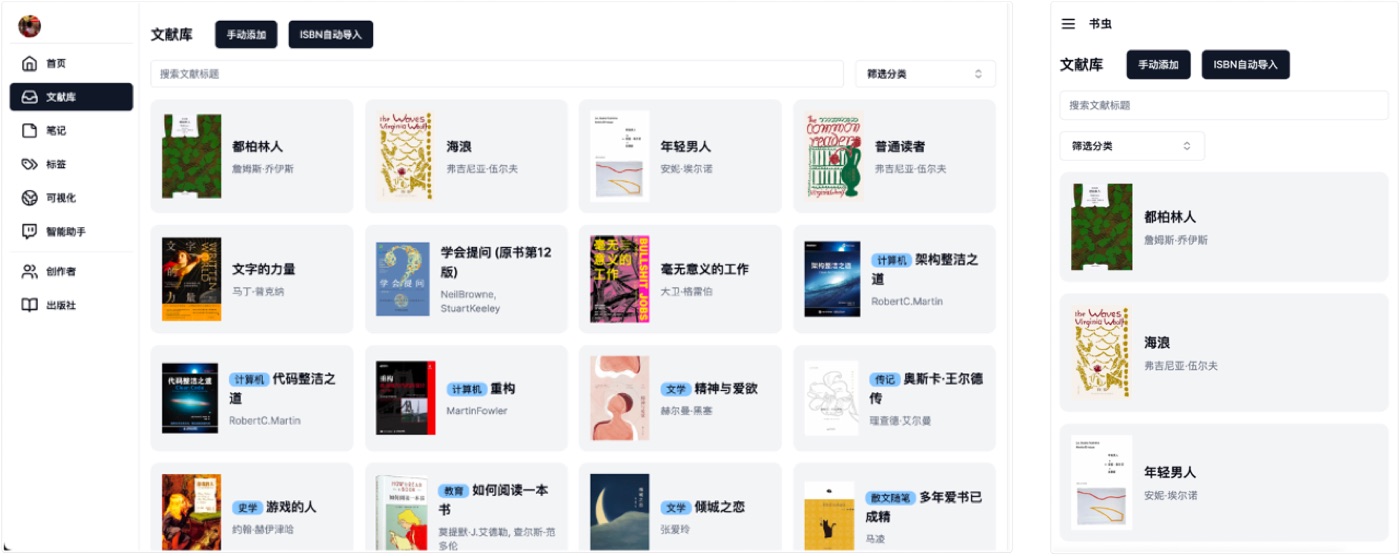
文献库页面,电脑和手机两种尺寸。应用里的名字叫“书虫”。
为什么做
Gap Year 那年我开始大量读书,文学、哲学、心理学都读。当时用 Readwise 记笔记,可我读的是纸质书,每条摘抄和感想都要进网页手动敲。
我就想利用他们的 OpenAPI,做一个可以随时记录笔记的 H5 端……我就想,费这么大功夫就对接 Readwise,也太可惜了,不如就做大一点,好用一点,变成毕业设计吧!
答辩时我把问题归成两句:笔记总是“吃灰”;书和书之间有错综复杂的联系,却看不见。
为谁做
用户就是像我这样的读者:
- 想靠记笔记加深理解;
- 有人读纸质书,有人读电子书,两种都要能记;
- 会读翻译过来的书,所以录书时要能填译者和原名。
我从自己记笔记的习惯出发:记书的信息(书名、作者、ISBN),记笔记(摘抄加感想),给笔记打标签。还有一件我最想要的:
我还想看笔记之间的关系,这才是我的 App 的核心价值——看出书与书之间是怎么联系在一起的。
写论文时也比较了 Notion、Obsidian、flomo 这几款笔记软件,还有卢曼的卡片盒笔记法。
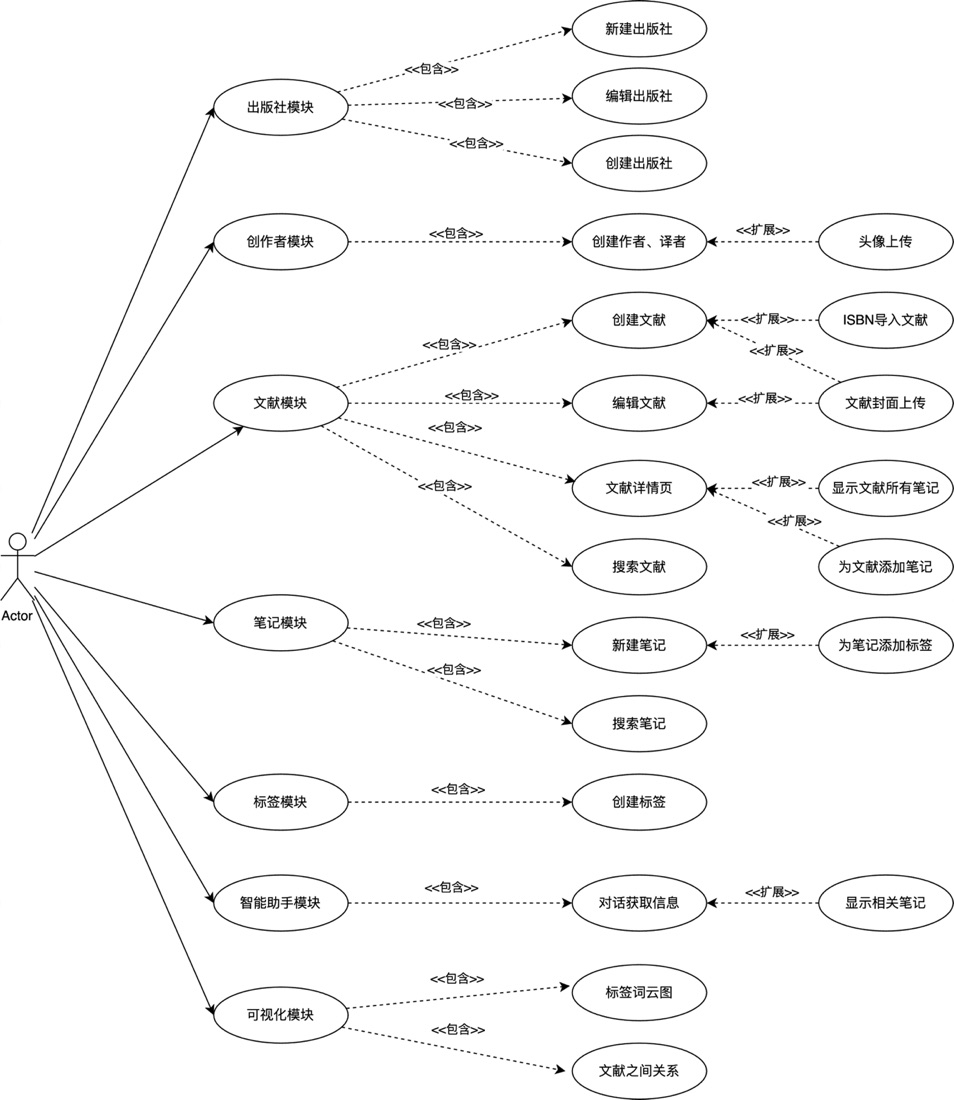
论文里的用例图。
设计
整个流程是一个圈:录书 → 记笔记 → 用智能助手翻笔记 → 看数据和关系图。
- 录书:扫一下 ISBN,自动从豆瓣抓书的信息;出版社、作者、译者可以先建好再选。
- 记笔记:摘抄和感想分开记,可以打标签。
- 关系图:书、作者、标签是点,它们之间的关系是线,用力导向布局(ForceAtlas2)自动排开。另有一张标签词云。
- 智能助手:问它“我关于某个主题记过什么”,它从你的笔记里找出相关的几条,再组织成回答。
- 手机优先:先按手机屏幕设计,屏幕宽到 768px 再换成电脑的布局。
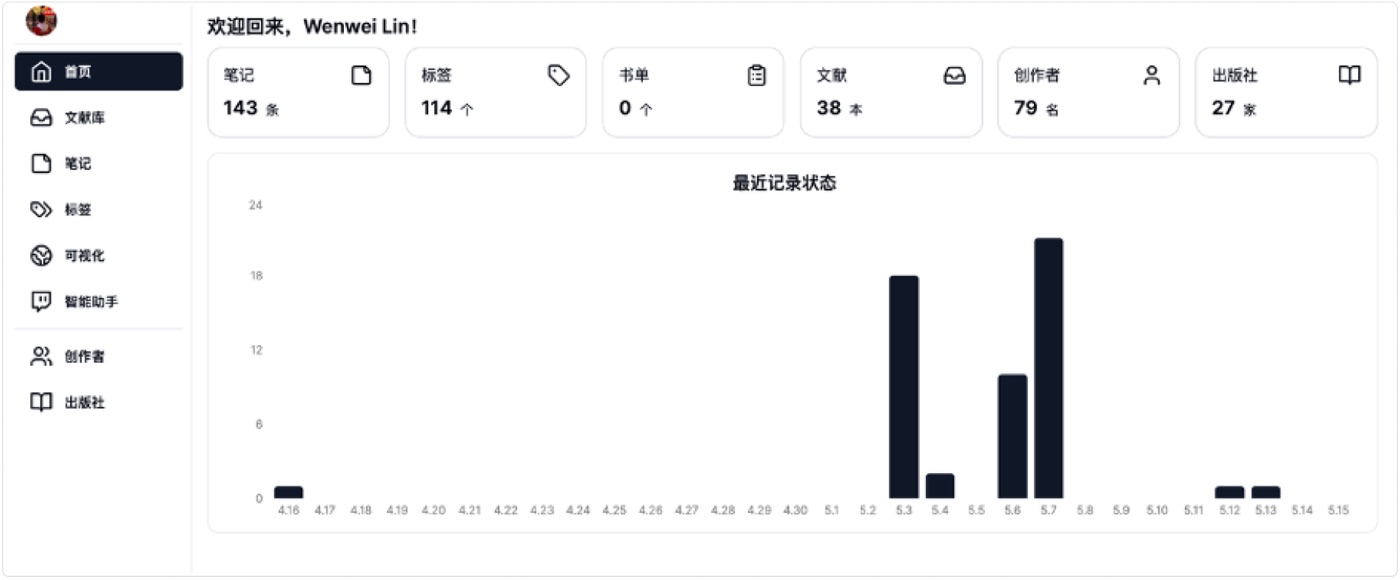
首页:一共记了多少条笔记、多少个标签,最近哪几天记得多。
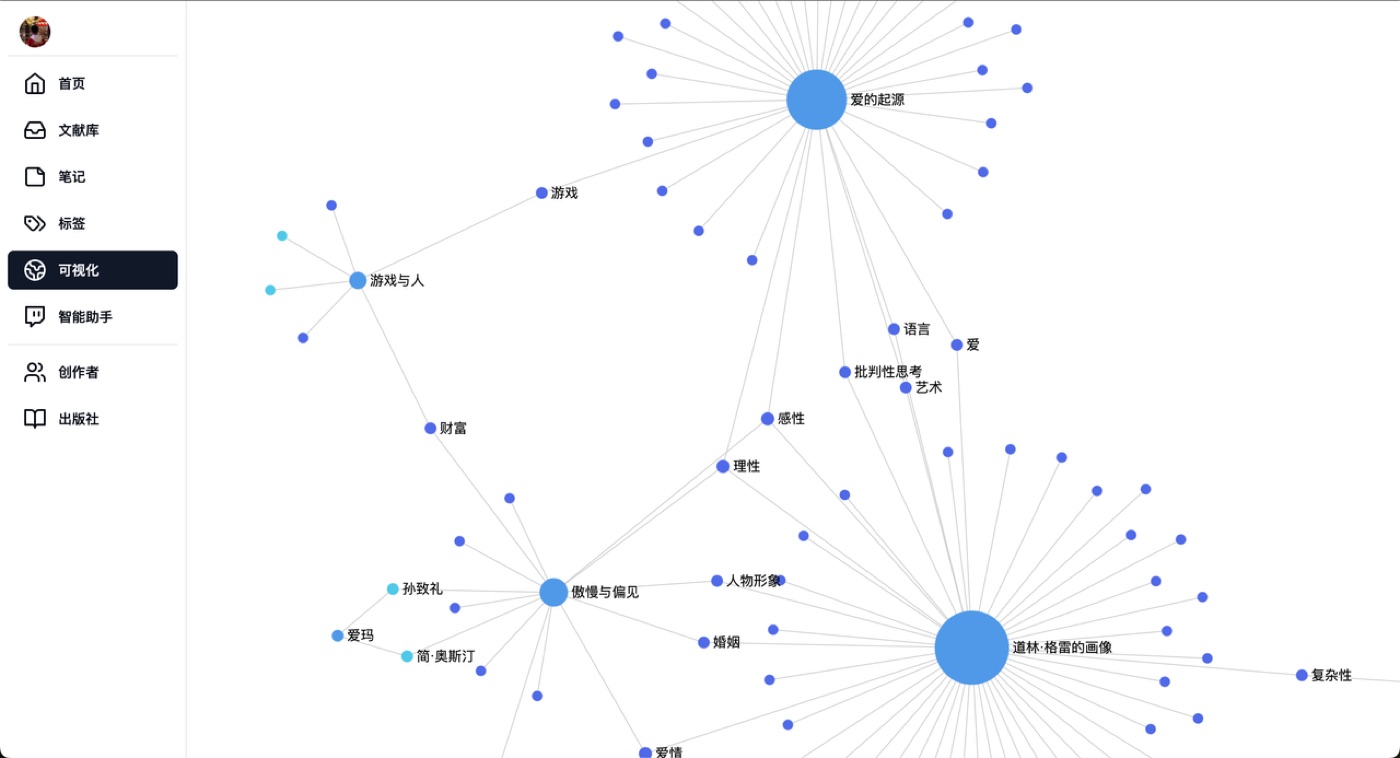
关系图的一角:《傲慢与偏见》和《道林·格雷的画像》通过“理性”“感性”这些标签连在了一起,这是我最想看到的东西。
技术选型和取舍
图数据库。 我是在微软的 Global Azure 2023 活动上第一次知道图数据库的,“感觉他好酷”:书和作者、书和笔记、笔记和标签,天然就是一张图。做到可视化那一步我才发现:
不一定要图数据库才能做图的可视化,可视化是前端的东西,你只需要给前端要的数据结构就行。而图数据库,只是能加速这种场景的数据库查询(但我的数据量太小了,完全体现不出图数据库的优势)。
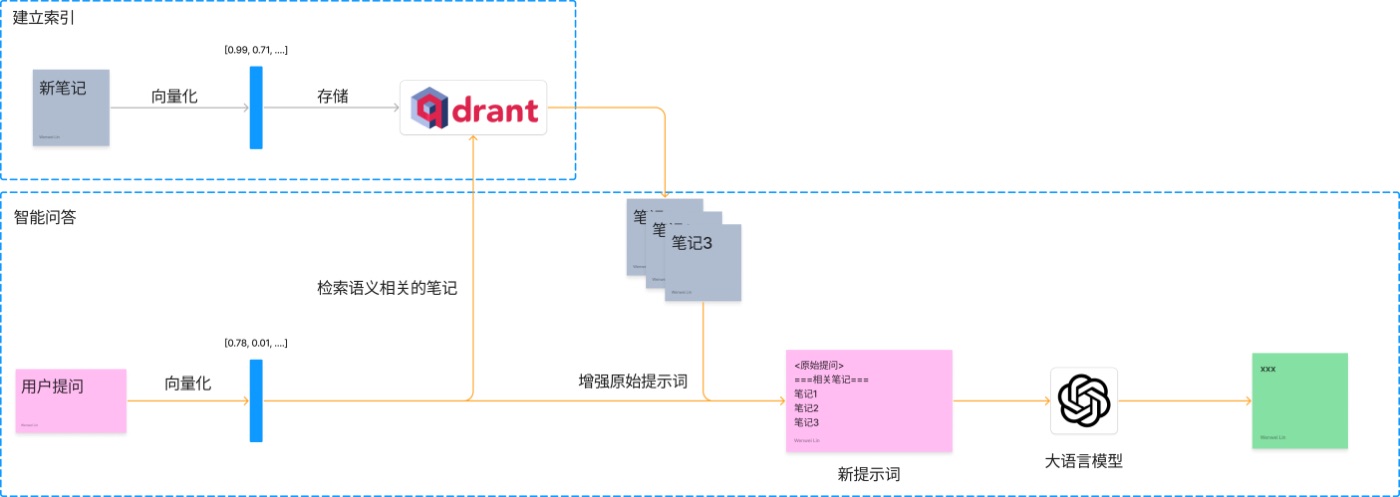
用自己的笔记问答(RAG)。 笔记常常在文件夹里吃灰,组织语言也费劲。把笔记切成小段存进向量数据库(Qdrant),提问时先找出最相关的几条,再交给大模型回答,它就能“照着你的笔记”说话,少编造。
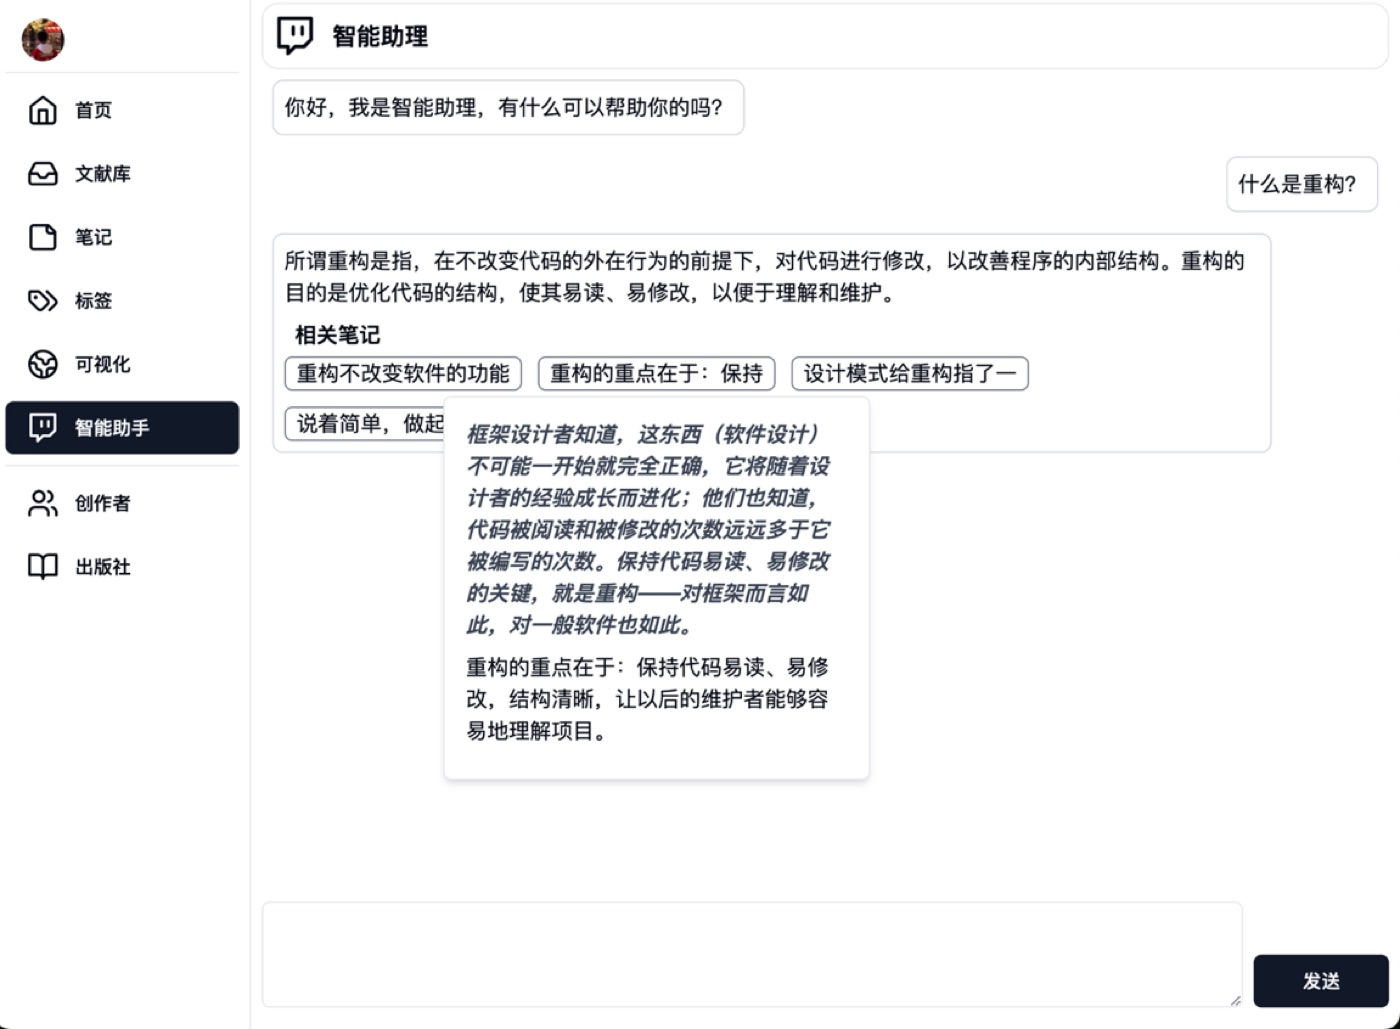
问“什么是重构?”,回答下面列出用到的几条笔记,点开就是当时的摘抄和感想。
Server Component。 实习时我写的都是 React 的客户端组件,这次想试试 Next.js 的服务端组件:组件本身就是异步的,直接在里面查数据,不用再写 useEffect。
登录。 本来想前后端分开,再写一个后端 API,“但后端我发现认证那个不会写,那我就算了”,用了现成的 Clerk。“感觉认证不是最重要,最重要是其他功能,所以做取舍吧。”
开发时我发现用到的一个 shadcn 风格的标签组件有问题,顺手给它提了 PR。
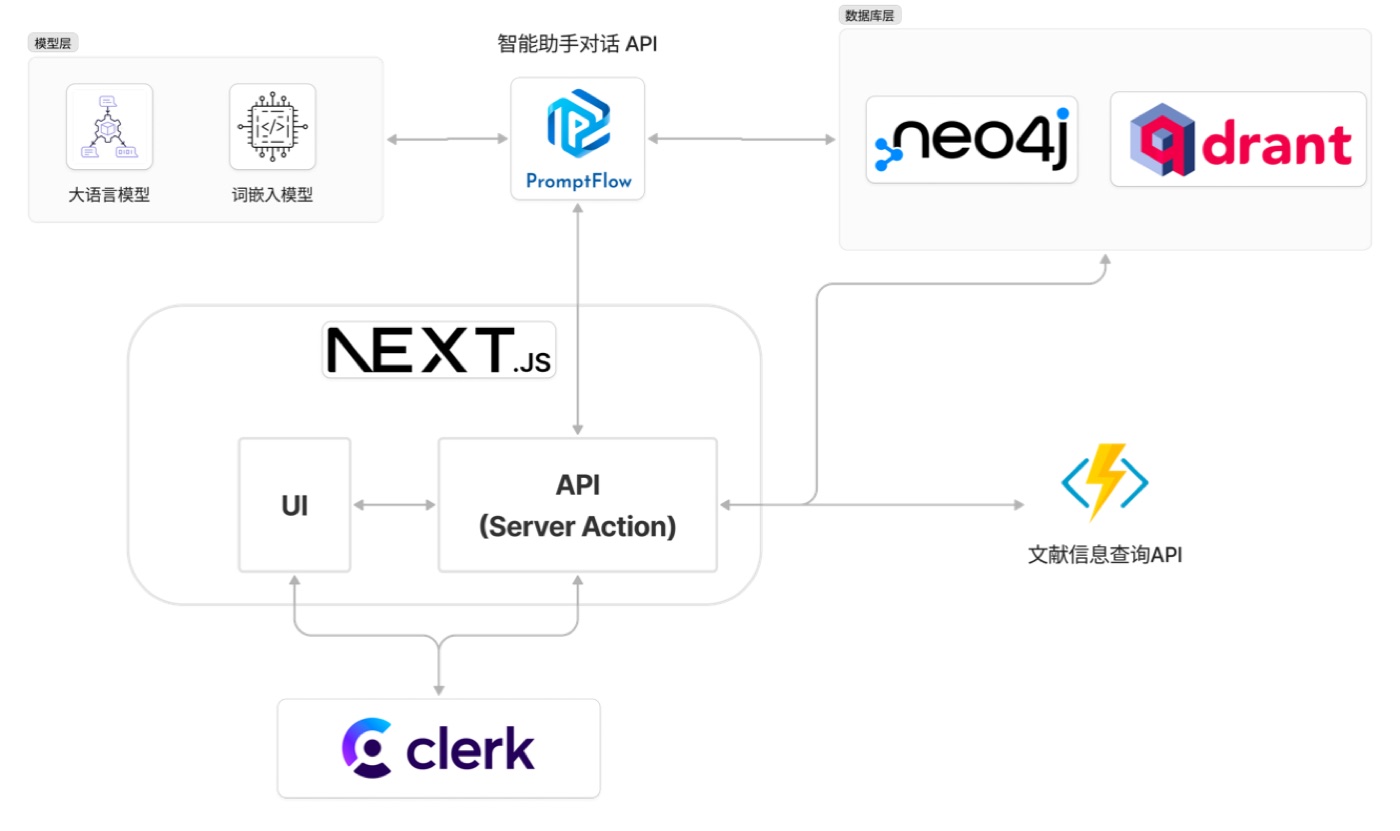
整体架构:一个 Next.js 全栈应用,连着图数据库、向量数据库和大模型;扫 ISBN 查豆瓣的接口单独部署成无服务函数。
测试
我存了 100 条读书笔记,出了两类问题,各 34 道:答案就在笔记里的,和笔记里没有、要靠推理或常识的。
| 答案在笔记里 | 笔记里没有 | |
|---|---|---|
| GPT-3.5 Turbo | 74% | 79% |
| Kimi Chat | 79% | 85% |
| GPT-4 Turbo | 82% | 85% |
| Bookworm | 91% | 56% |
答案在笔记里的问题,Bookworm 答得最准;笔记里没有的,就不如直接问大模型。
回头看
最后拿了优秀毕设。论文最后写的不足是:我用的是最基础的 RAG,找出来的笔记有时和问题不相关,可以往更复杂的做法走。
我在他上面倾注了很多心血,差不多把大学这几年来学过的知识都用上了,还有自己的学习能力。
那一年我白天实习,晚上和周末做毕设,最后一个月请了好几天假在家写论文。